데이터 셋은 Train data와 Test data로 구성되어 있으며 다음과 같습니다.
Train data : 예측 모델을 만들기 위해 사용하는 데이터 셋
Test data : train data로 만든 모델을 가지고 예측할 데이터 셋
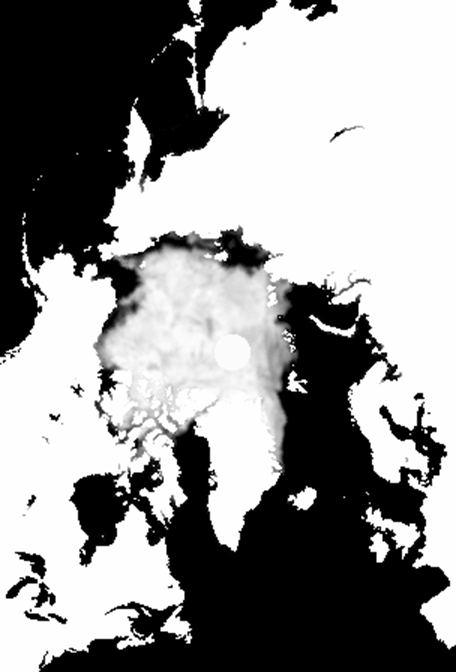
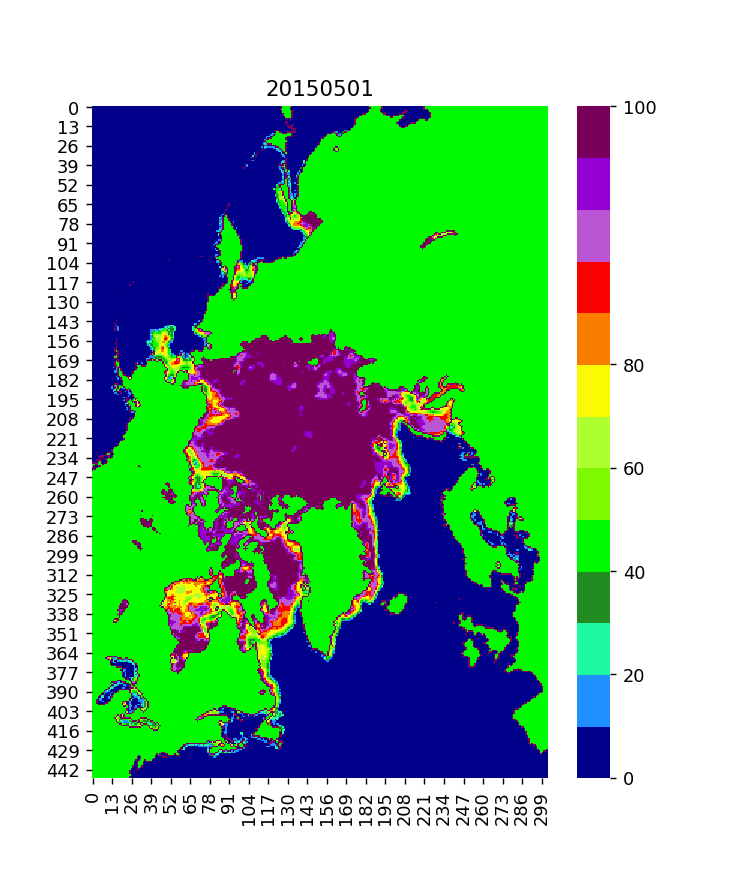
이미지화 한 데이터 예시 ( ※ 좌우 이미지의 시점은 일치하지 않습니다)
이미지화 한 데이터 | 컬러 스펙트럼을 적용한 이미지 |
|---|---|
 |  |
수동마이크로 센서에서 산출된 일간 해빙농도 값의 데이터입니다.
1978년부터 현재까지 매일 생산되는 자료로 하나의 픽셀당 25km x 25km의 공간영역을 가집니다.
북극해 전체에 대한 해빙농도 정보는 8bit 흑백 .png 형태로 저장되며 448 x 304개의 픽셀로 구성됩니다.
이미지로부터 array화 한 해빙농도 값은 0 – 255의 자연수 값이며, 같은 위치의 픽셀은 같은 지리적 위치에 대한 해빙농도 정보입니다. 보다 상세히 이하의 값을 가집니다.
수치 | 내용 |
|---|---|
0 ~ 250 | 바다 및 해빙 농도 |
251 | 위성 관측 맹점 영역 (북극점 등) |
253 | 해안선 |
254 | 육지 |
해빙농도는 지리적 위치마다 계절적 변동성을 보여줍니다.
입출력 정의
각 시퀀스별로 입력 60장과 출력 15장을 제공하고 입력의 이용은 자유, 출력은 15장 출력을 목표로 합니다.
데이터 트리
압축 파일에 train 과 test 폴더가 포함되어 있습니다.
train 안에는 총 6,231 개의 시퀀스별 폴더가 있고, 각 시퀀스 폴더 안에는 inp, tar 폴더가 있어 inp 폴더 안에는 60장의 입력 데이터가, tar 폴더 안에는 15장의 출력 데이터가 있습니다.
test 안에는 총 1,000개의 시퀀스별 폴더가 있고, 각 시퀀스 폴더 안에는 60장의 입력 데이터가 있습니다.
데이터 로드
개별 이미지 데이터는 다음의 코드를 통해 448 x 304 크기의 단일 깊이 array로 변환하고, 다시 이미지로 저장할 수 있습니다.
# 개별 파일 불러오기
file = './test/0001/0001_inp_01.png'
from PIL import Image
im = np.array(Image.open(file))

# 또는
file = './test/0001/0001_inp_01.png'
from imageio import imread
im = imread(file)

# 학습 및 추론 ...

# 저장하기
sv = Image.fromarray(pred)
sv.save('./label/0001_tar_01.png')
참가자는 총 15,000장의 데이터(1,000개의 시퀀스 * 15장)를 제출해야 합니다.
15,000장의 데이터를 제공된 prediction.csv에 있는 파일 순서대로 이름을 부여하여 저장합니다. (압축 파일에 포함된 prediction.csv입니다.)
전체 15,000장의 파일을 하나의 .zip으로 압축하여 제출합니다.
본 경진대회는 1st랩으로 총 1개의 랩으로 진행이 됩니다.
제공되는 데이터셋은 다음과 같습니다.
랩 | 예상시기 | Train Data | Test Data |
|---|---|---|---|
1st랩 | 2020.11.23~2020.12.02 | 아래 참고 | 아래 참고 |
※ 대회의 원할한 진행을 위해 일정은 변경될 수 있습니다.
train.zip (다운로드 링크): 총 6,231개의 시퀀스별 폴더와 각 폴더 내의 입출력 데이터.
test.zip (다운로드 링크): 1,000개의 시퀀스별 폴더와 입력 데이터.
prediction_sample.zip (다운로드 링크): 정답 생성에 필요한 prediction_list.csv (해당 csv에 기재된 순서 확인 후 유지) 및 생성된 결과 샘플. 실제 결과 제출시에는 해당 순서대로 파일명을 부여하여 저장하고, zip으로 압축해서 제출하여야 합니다.
filter.npy ([다운로드 링크]): (2020.12.02) 평가 결과 산정에 사용하는 필터 파일입니다. 자세한 활용방법은 개요탭의 [6.1 평가방법]을 참고바랍니다.