(24.11.08 12:00) 중급 스코어 산출식(sklearn.fbeta_score)에 오류가 있어 정정하였습니다. 전체 제출분에 대하여 오류 수정이 완료되었습니다.
스코어에 변동이 있으니 리더보드 확인 부탁드립니다.
부품 가공 공정에서 발생한 이상 시점을 비지도학습 방식으로 탐지하는 과제입니다.
공정의 구조 및 데이터 특성은 다음과 같습니다.
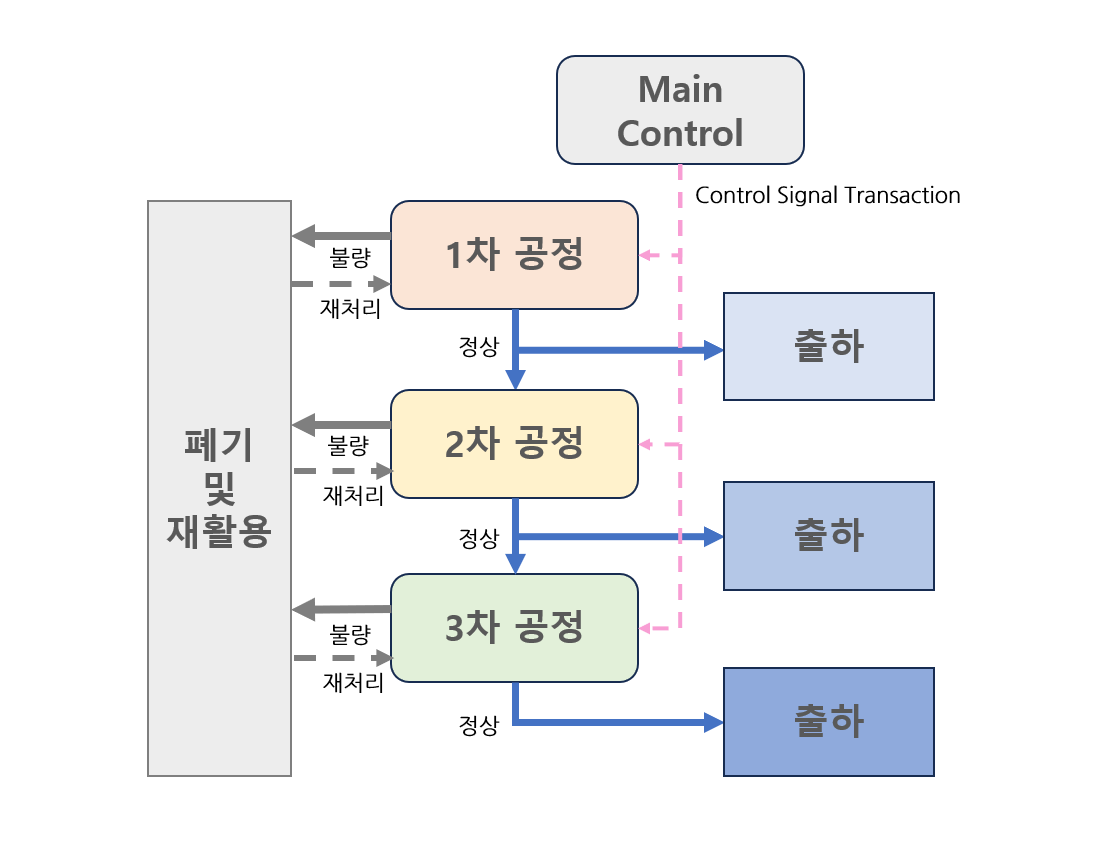
각 공정은 복수의 생산라인(LANE)으로 이루어져 있습니다.
각 공정에서는 생산된 부품의 정상(NOR)/불량(DEF)의 판정을 수행합니다.
정상 부품의 경우 일부는 바로 출하되고 일부는 다음 단계의 어셈블리 공정으로 넘어가서 추가적인 가공을 거치게 됩니다
불량 부품의 경우 일부는 폐기되고 일부는 공정에 재투입됩니다
1) 기본 정보
데이터는 각 공정(P1, P2, P3)의 LANE별 입력(inItems) / 정상 가공(NOR) / 불량 가공(DEF)과 메인 컨트롤에서 각 공정과 통신하는 신호의 총합(CON_SIG)으로 이루어져 있습니다.
각 row의 시간(Timestamp)은 측정 시작 시점을 기준으로 기록되어 있으며, 모든 값은 5분 단위의 누적합입니다.
2) 특이 사항
이상 시점은 실제 공정의 이상 시점에 해당되며, 해당 시점은 제공된 데이터로부터 유추될 수 있습니다.
특정 시점에서 모든 공정, 모든 생산 라인 가운데 하나라도 이상인 경우 이상 시점으로 취급합니다.
결측치(NaN)는 단순 누락으로 이상을 의미하지는 않습니다.
각 공정에서 다음 공정으로 넘어가기 전에는 부품이 한 번 취합되어 넘어가기 때문에 공정당 LANE의 수가 동일하지 않습니다.
LANE별 작업 속도가 완전히 동일하지 않기 때문에 적체나 생산량 차이가 항상 존재합니다.
각 공정 처리는 순차적으로 이루어지고 재처리 등의 수량이 존재하기 때문에 동시점 1차 공정의 총량과 2, 3차 공정의 생산량은 동일하지 않습니다.
🗂️task2.zip
├─ 📈Task2_data.csv - 데이터 파일
└─ 🗒️answer_sample.csv - 정답 샘플
본 과제의 평가에는 macro 방식의 F2-Score가 사용됩니다.
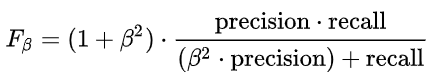
실제 평가 스크립트는 scikit-learn의 fbeta_score 함수를 활용합니다. 파라미터가 적용된 해당 함수의 명령은 다음과 같습니다.
from sklearn.metrics import fbeta_score
score = fbeta_score(y_true, y_pred, beta=2, average='macro')
점수는 Public:Private 3:1로 분할 평가되며, 대회기간중에는 Public Score만 제공됩니다.
Private Score를 포함한 Total Score는 대회 종료 시점에 공개되며, 최종 순위는 Total Score를 바탕으로 산출됩니다.
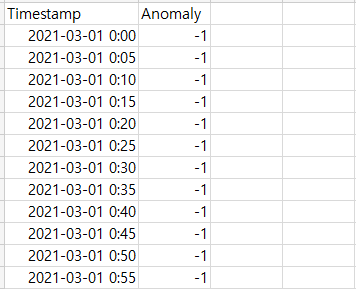
위 answer_sample.csv의 각 시점에 Anomaly 값을 0 또는 1로 채워서 제출합니다(0:정상, 1:이상)
1시간마다 1회 제출이 가능합니다. (정상 제출 이후 재제출까지 1시간 필요)
중급 태스크는 동점자 발생 시 먼저 스코어를 기록한 팀의 순위가 우선됩니다.
※ 외부 데이터 사용 관련
제공 데이터 외 외부 데이터 사용 금지
사전학습모델(Pre-trained Model)은 사용할 수 없음