제1회 철도인공지능 경진대회 데이터셋이 업로드 되었습니다.
상단의 ‘데이터 다운로드’ 버튼을 클릭하여 상세 내용 확인 부탁드립니다.
주어진 주행데이터 및 선로데이터를 이용하여, 탈선계수에 해당하는 이하 4개 항목을 예측하는 모델을 만듭니다.
YL_M1_B1_W1: 좌측 전위 차륜 탈선계수
YR_M1_B1_W1: 우측 전위 차륜 탈선계수
YL_M1_B1_W2: 좌측 후위 차륜 탈선계수
YR_M1_B1_W2: 우측 후위 차륜 탈선계수
직선구간(data_s) 데이터와 곡선구간(data_c)데이터가 yaw damper의 비선형제어능력 조건에 따라 각 5개씩 주어집니다(30, 40, 50, 70, 100).
총 10개 데이터 파일마다 탈선계수 4열씩, 총 40열의 데이터를 예측합니다.
실제 데이터는 3km 길이 만큼 주어지며, 예측 대상은 마지막 500m에 해당되는 구간입니다.
모델은 반드시 다음의 조건을 충족해야 합니다.
각 탈선계수의 과거 시점 값 또는 각 탈선계수의 자기상관 데이터를 독립변인으로 사용하는 시계열/패널 유형 모델일 것
탈선계수의 과거 시점 값(t-1 … t-M)과 그 외 변인들(예: 구간 정보)의 대상 시점 값(t … t+N)을 함께 활용하여 예측 수행
예측 시 사용할 과거 시점 값의 길이와 한 번 예측에서 생성할 예측 시점의 길이는 자유
한 번에 전체 대상 시점에 대한 예측 생성이 어려운 경우, 생성한 예측을 다시 입력으로 활용하여 다음 시점을 생성하는 모델을 구축
전체 단일 모델 또는 직선구간 모델과 곡선구간 모델의 형태로 모델을 생성할 것
직선구간과 곡선구간 데이터의 선로 정보 구성 항목이 서로 다른 점에 유의
앙상블에 대한 제약은 없으나, 2차 평가항목에 활용성이 포함되어있음에 유의
※ 설명 보충:
- 입력 데이터는 크게 1) 탈선 계수의 과거 값, 2) 예측 대상 탈선 계수와 동시점 및 과거 시점의 다른 독립변인 값 (lane data와 탈선 계수를 포함한 각 시트에서 탈선 계수 외의 나머지 모든 변인값)으로 구분됩니다. 문제가 요구하는 사항은 1)과 2)를 모두 사용하거나 차원 축소, 변인 선택 등을 활용하더라도 탈선 계수의 과거 값은 어떠한 형태로든 반드시 포함해야 한다는 것입니다. 1) 없이 2)의 값만을 활용하시게 되면 운행중 이후 구간이 아니라 동시점의 값을 생성하는 것이 되어 모델의 의미가 없어지게 됩니다.
반드시 사용해야 하는 독립변인: 탈선계수의 과거값(과거 얼마만큼을 사용할 것인지는 자유)
사용할 수 있는 독립변인: 탈선계수 외 나머지 모든 변인들의 예측 대상 시점 값과 그 이전의 과거값
사용할 수 없는 독립변인: 예측 대상 시점보다 미래의 값 모두
- 탈선 계수의 과거 시점 값을 반영하는 방법은 RNN에서와 같이 시간에 대한 차원을 두어 반영하는 방법도 있고, 혹은 2차원 테이블에 다른 변인과 함께 과거 시점 값 또는 과거 시점의 차분 값을 열 항목으로 만들어 넣고 사용하는 방법도 있겠습니다. 생각하시는 모델에 따라 활용 방법은 자유입니다.
- 하나의 모델이(앙상블 허용) 요댐퍼 조건을 파라미터로 받아서 5가지 요댐퍼 조건에 대한 값을 예측할 수 있어야 합니다. 다만 직선 구간 데이터와 곡선 구간 데이터의 경우 lane_data를 구성하는 항목이 서로 다르기 때문에 서로 다른 변인들이 활용될 수 있는 점을 고려하여 구간별로는 별도의 모델을 활용하셔도 되겠습니다.
- 활용성 평가 항목의 경우 과도하게 복잡한 앙상블을 구성하게 될 경우, 비슷한 성능이 나오면서도 더 간결한 모델이 보다 좋은 평가를 받을 가능성이 있겠습니다.
📁 dataset.zip
 ├--- 📃 data_columns.csv                      --- 주행데이터 컬럼 정보 (utf-8)
 ├--- 📃 lane_data_columns.csv                  --- 선로데이터 컬럼 정보 (utf-8)
 ├--- 📃 차량_및_요댐퍼.xlsx                 --- 차량 및 yaw damper 관련 정보 (단순 참고용)
 ├--- 📃 lane_data_s.csv                   --- 3km 직선 구간 선로 데이터
 ├--- 📃 lane_data_c.csv                   --- 3km 곡선 구간 선로 데이터
 ├--- 📃 data_sXX.csv                   --- 3km 직선 구간 주행 데이터. (각 숫자는 yaw damper의 비선형제어능력 조건)
 ├--- 📃 data_cXX.csv                   --- 3km 곡선 구간 주행 데이터. (각 숫자는 yaw damper의 비선형제어능력 조건)
 └--- 📃 answer_sample.csv          --- 정답 양식 파일
평가 메트릭은 예측 대상 시점별로 가중치가 부여된 MAPE를 사용합니다.
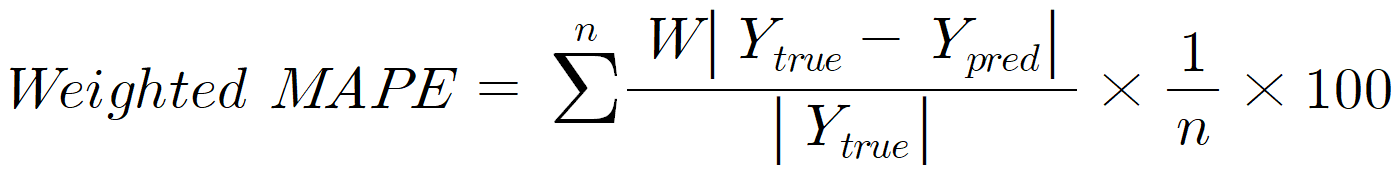
가중치 W는 시점에 따라 최초 시점의 1.0001에서 마지막 시점의 1.1999까지 선형 증가합니다.
모델의 정상적인 예측수행으로부터 생성되지 않은 결과는 최종 무효처리됩니다.
◼︎ 팀 참가 관련
한 팀의 인원 제한은 최대 4명입니다.
참가자격에 부합하는 분에 한해 참여 가능합니다.
결과물 제출은 반드시 팀 대표 1인의 아이디로 제출 부탁드립니다.
◼︎ 예선 관련
공공 데이터 외의 외부 데이터는 법적인 제약이 없는 경우에만 사용 가능합니다.
사전학습(Pre-trained) 모델 사용을 허용합니다.
1일 내 제출은 5회로 제한되며, 재 제출은 1시간 뒤 가능합니다.
Public 및 private 스코어가 합쳐진 total 스코어로 최종 순위 및 검증 대상 결정 (Public 및 private의 비율은 1:1)
대회기간 중에는 public 스코어만 리더보드 상에 표출
대회 종료시점 이후 public 및 private 스코어가 합쳐진 total 스코어와 그에 따른 순위가 리더보드 상에 표출됨
코드 결과물 제출 및 검증
입상후보팀으로 선정되는 경우 아래 저작물을 cs@aifactory.page 로 일괄 제출 (코드와 주석의 인코딩은 모두 UTF-8을 사용)
작성 코드 : *.py 또는 *.ipynb
최종 1회 제출
학습용 소스와 추론용 소스를 별도의 파일로 분리하는 것을 권장
검증자료 제출 시 사용한 python 버전, OS버전 필수 기재
특히, 특수 패키지를 사용하는 경우 반드시 python 패키지 명시
모델 가중치(weight) 파일 또는 저장된 모델 :
딥러닝 계열로 weight가 파일로 저장되는 경우 저장된 weight
그 밖의 경우는 pickle/ joblib 등의 라이브러리를 이용해 dump한 모델
모델 설명서 : *.docx (양식 보기)
◼︎ 그 밖의 대회규칙은 ‘개요’ 탭 내 대회 규칙을 따릅니다