Household Power Consumption(UCI Machine Learning Repository) 데이터셋
‘dt’(index), ‘Global_active_power’, ‘Global_reactive_power’, ‘Voltage’, ‘Global_intensity’, ‘Sub_metering_1’, ‘Sub_metering_2’, ‘Sub_metering_3’ 총 7개의 열로 구성되어 있습니다.
target 데이터는 ‘Global_active_power’
참가자 분들은 자유롭게 시계열 모델을 개발하되, x_test의 shape은 (1728, 6, 6), y_test의 shape은 (1728,) 입니다. 해당 내용을 유의하셔서 제작하시면 됩니다.
자세한 설명은 아래에 있는 ‘x_test, y_test 설명’을 참조해 주세요.
학습 및 평가 데이터 각각의 샘플 수는 다음과 같습니다.
학습 데이터 샘플 수 : 27,671
평가 데이터 샘플 수 : 1728 (묶음 기준)
time_series_train.csv - 총 7개의 열로 되어있는 데이터셋 입니다.
‘Global_active_power’ : target 값이고, 가정용 글로벌 시간 평균 유효 전력 (kW : 킬로와트)
‘Global_reactive_power’ : 가정용 글로벌 시간 평균 무효 전력 (kW : 킬로와트)
‘Voltage’ : 시간 단위 평균 전압
‘global_intensity’ : 가정용 글로벌 시간 평균 전류 강도(A : 암페어)
‘sub_metering_1’ : 에너지 보조 계량 1번, 주로 식기세척기, 오븐, 전자레인지가 있는 주방에 해당 (Wh : 와트시)
‘sub_metering_2’ : 에너지 보조 계량 2번, 세탁기, 회전식 건조기, 냉장고 및 조명을 포함하는 세탁실에 해당 (Wh : 와트시)
‘sub_metering_3’ : 에너지 보조 계량 3번, 전기온수기와 에어컨에 해당 (Wh : 와트시)
‘dt’ : yyyy-MM-dd HH:mm:ss 형식의 datetime (index로 사용)
time_series_train.csv는 결측값이 존재하는 데이터입니다. (평가 데이터에는 결측값이 없습니다.) 참가자 분들이 데이터를 통해 다양한 방법으로 결측값 처리를 수행하시면 됩니다.
x_test는 (1728, 6, 6) 형식의 행렬입니다.
x_test는 6개의 time step, 6개의 feature로 구성되어 있습니다.
x_test의 각 features는 ‘Global_reactive_power’, ‘Voltage’, ‘Global_intensity’, ‘Sub_metering_1’, ‘Sub_metering_2’, ‘Sub_metering_3’로 구성
이전 6시간을 입력 → 마지막 입력으로 부터 4시간 후를 예측 → 이후 stride가 4이므로 2개씩 겹치게 데이터 이동
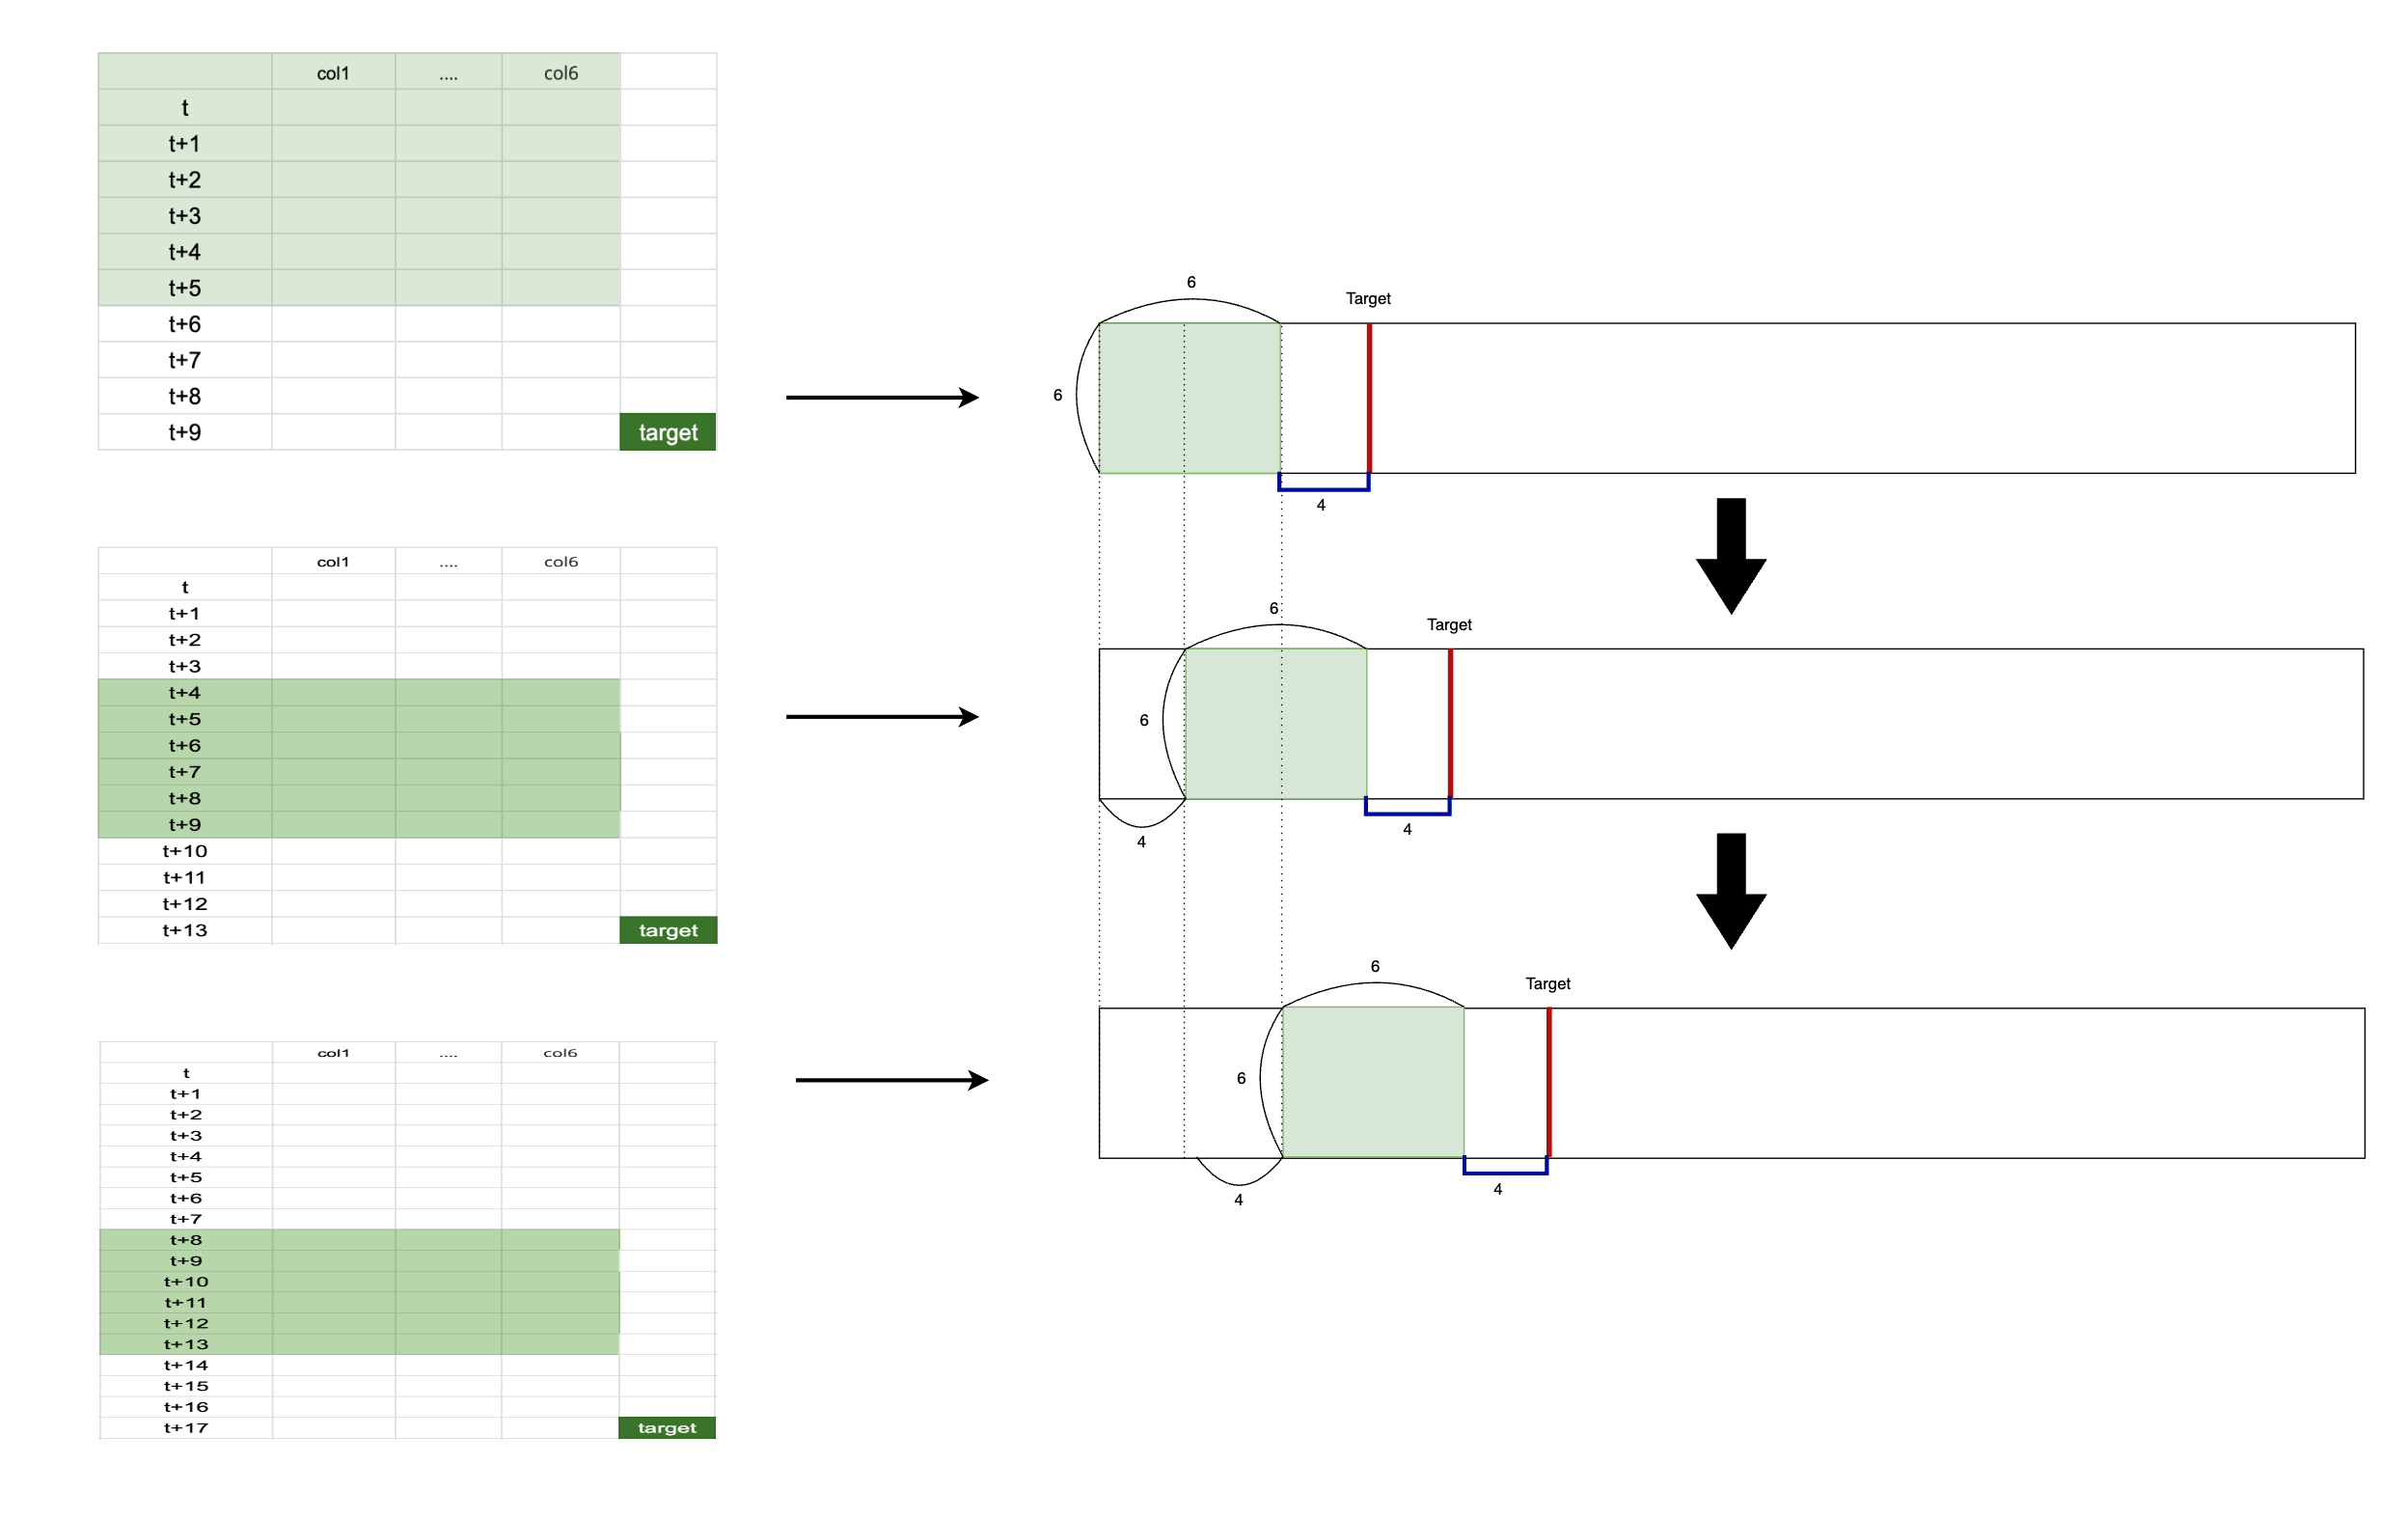
y_test는 (1728,) 형식의 행렬입니다.
최종 예측을 y_test와 같은 차원의 행렬로 변환하여 제출해 주세요.
추론자동화에서 입력되는 x_test의 shape은 (1728, 6, 6) 이고, stride는 4입니다. 참가자 분들이 x_test의 shape 바꾸는 코드를 넣어서 6묶음씩 학습하지 않고 3묶음 혹은 다른 묶음으로 변환해서 추론하셔도 문제없습니다. (예시 : many-to-one의 구조로 수행후 예측치 중 6묶음과 같은 위치의 예측치를 모아서 제출하는 방법)
하지만, y_test는 (1728,) 이므로 같은 개수의 추론이 나와야 합니다.