전체 데이터는 다음의 파일로 구성되어 있습니다.
📁 dataset.zip
 ├--- 📃 train_data.csv                --- 학습용 데이터 파일
 ├--- 📃 test_data.csv                 --- 평가용 데이터 파일
└--- 📃 answer_sample.csv --- 정답 양식 파일train_data: 학습용 데이터로 모두 정상 case로 이루어진 데이터입니다.
test_data: 평가용 데이터로 정상 case와 이상 case가 함께 포함되어 있는 데이터로, 예측 대상에 해당됩니다.
answer_sample: test_data에 대하여 작성할 제출용 레이블 파일 양식입니다.
1. 데이터 구성 항목은 다음과 같습니다.
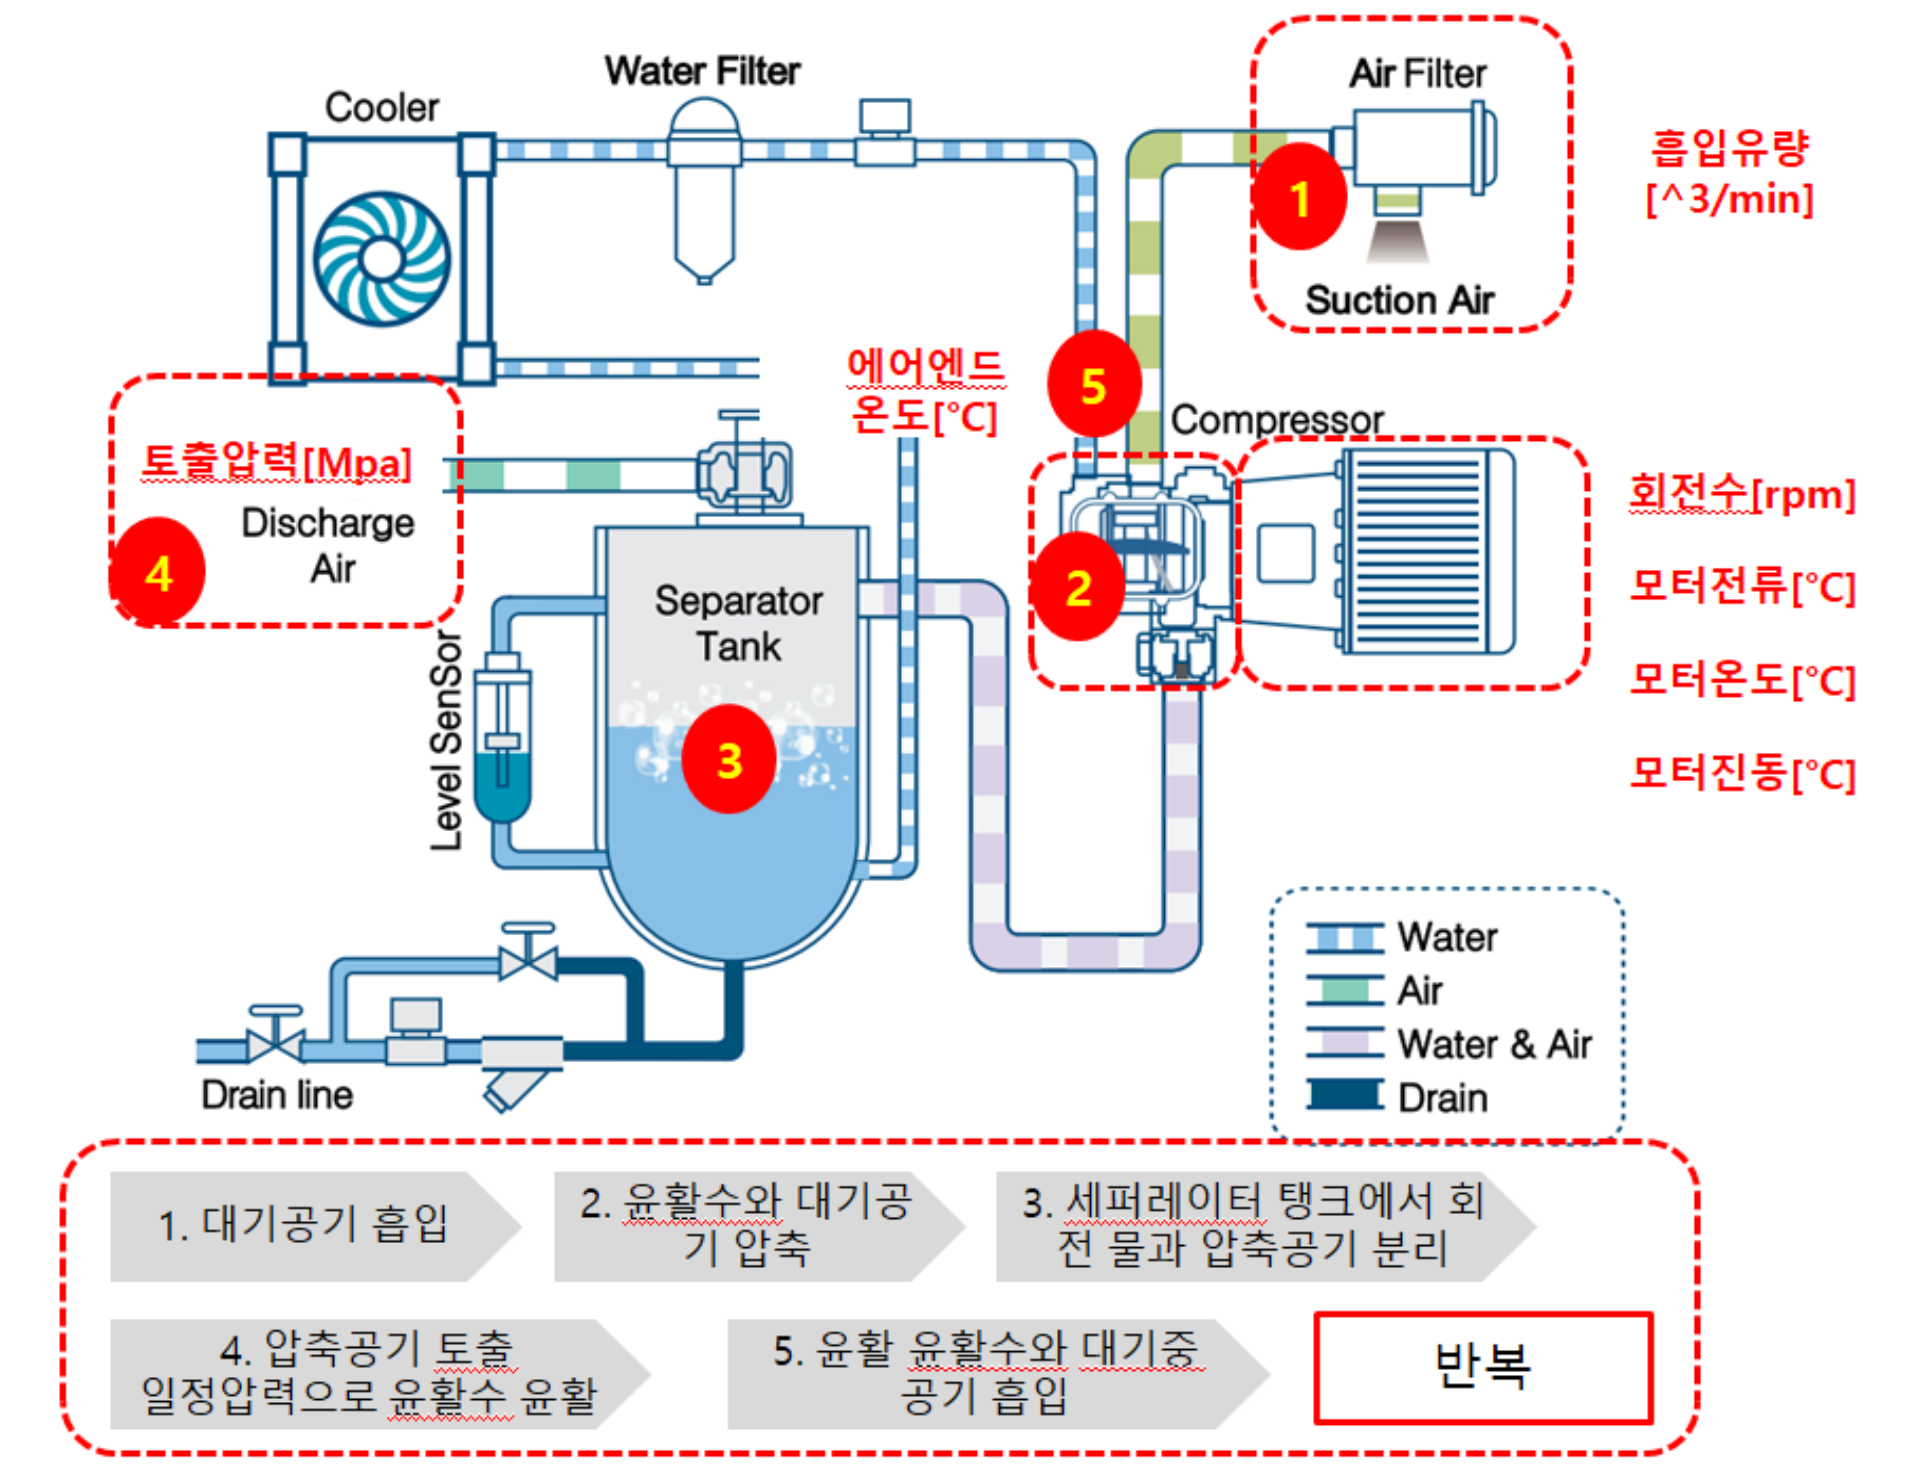
air_inflow: 공기 흡입 유량 (^3/min)
air_end_temp: 공기 말단 온도 (°C)
out_pressure: 토출 압력 (Mpa)
motor_current: 모터 전류 (A)
motor_rpm: 모터 회전수 (rpm)
motor_temp: 모터 온도 (°C)
motor_vibe: 모터 진동 (mm/s)
type: 설비 번호
2. 또한 설비별로 다음의 특성을 갖습니다.
설비 번호 [0, 4, 5, 6, 7]: 30HP(마력)
설비 번호 1: 20HP
설비 번호 2: 10HP
설비 번호 3: 50HP
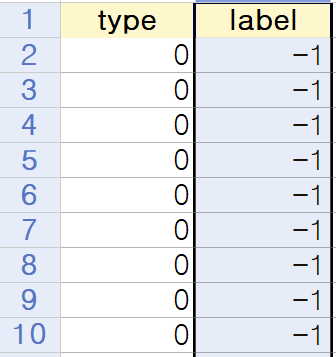
그림과 같이 type, label 두 개의 column으로 이루어진 answer_sample.csv의 양식에서 label을 예측 결과에 따라 0(정상) 또는 1(이상)로 작성하여 제출합니다.
csv의 row 배열 순서는 test_data.csv와 일치해야 합니다.