머신러닝/딥러닝이 좋은 성능을 보이며 각 분야에서 활용되고 있는 요즘, 머신러닝/딥러닝의 계산비용이 중요한 문제로 떠오르고 있습니다. 머신러닝/딥러닝 데이터를 입력으로 받아 결과를 내는 알고리즘인데 데이터의 양이 증가하면 증가할수록 계산량이 기하급수적으로 증가하게 되고, 이는 곧 많은 시간과 에너지의 소모로 이어지게 됩니다. 따라서 에너지 효율적인 알고리즘 기법이 필요합니다.
Dataset Condensation은 대용량의 데이터셋을 작은 용량의 데이터셋으로 응축/합성하는 기법입니다. 대용량의 데이터셋을 작은 데이터셋으로 합성하면서 그 성능 감소의 폭을 최소화 하기 때문에 높은 효율과 좋은 성능을 같이 얻을 수 있는 기술입니다. 따라서 Dataset Condensation 기술이 발전하여 인공지능 기술이 친환경적으로 발전하는데 이바지할 수 있도록, 위 대회를 개최하게 되었습니다.
Dataset Condensation은 대용량의 데이터셋을 작은 용량의 데이터셋으로 응축/합성하는 기법입니다.
데이터셋 합성에는 다양한 기법이 사용될 수 있지만, Dataset Condensation에서는 Gradient Matching이라는 기법을 사용해서 데이터셋을 합성합니다.
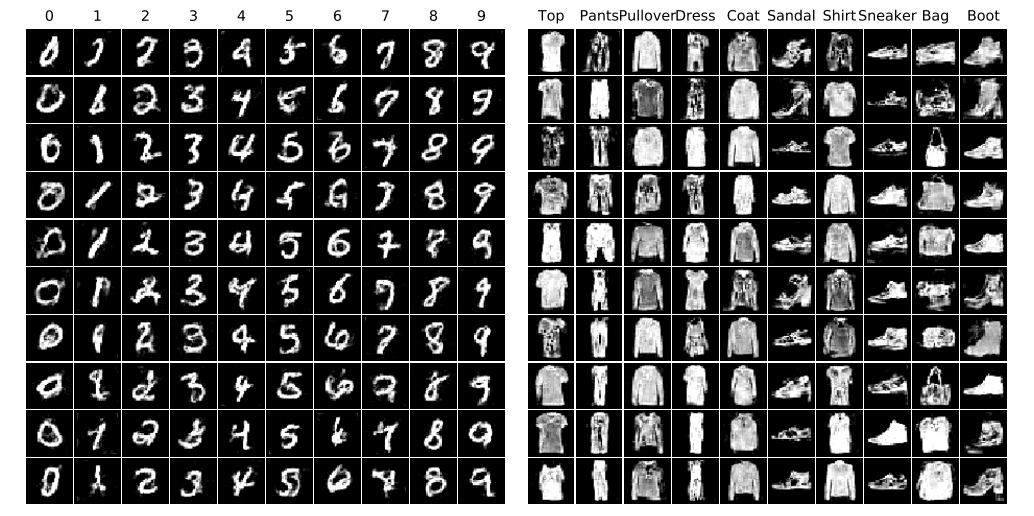
클래스별 합성된 데이터 예시
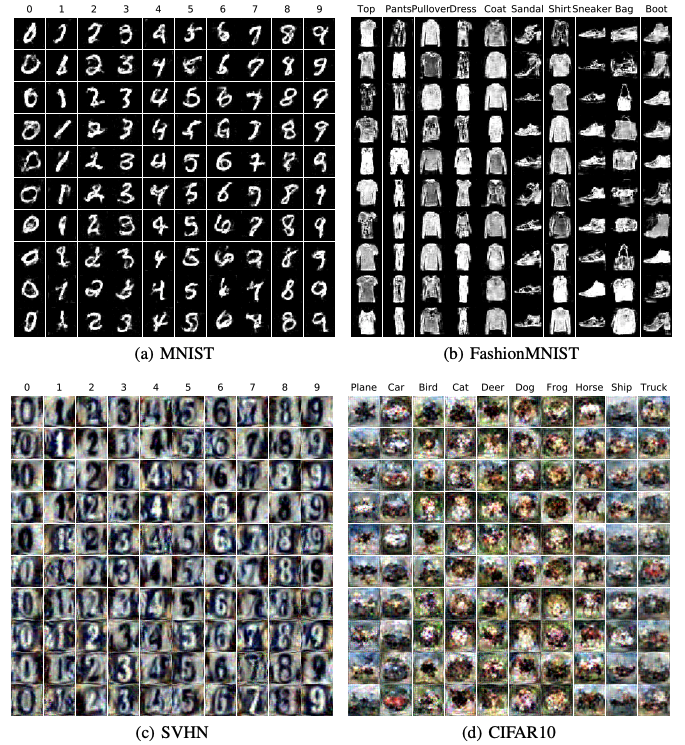
본 대회는 Fashion MNIST 데이터셋을 Dataset Condensation 기법을 사용해서 Class별로 하나의 이미지로 압축한 뒤 성능을 확인하는 Competition입니다.
베이스라인 코드를 돌려서 나오는 y_pred.csv 파일을 제출하시면 리더보드에 최종 스코어가 기록됩니다.
본 대회는 각 클래스별로 한 장의 이미지에 얼마나 중요한 정보들을 잘 압축한 이미지를 합성해 내는지 여부를 가리는 대회입니다.
따라서 결과를 출력해내기 위한 테스트 모델, 즉 VGG16 모델에 대해서는 일체의 수정을 금합니다.
Vgg16 모델은 합성된 이미지의 성능을 측정하기 위한 모델이므로 성능을 향상시키는 것과 관계가 없습니다. 즉, 베이스라인코드의 12.테스트할 모델 정의 ~ 15.결과 생성 및 저장 부분은 코드를 수정하시면 안됩니다. 클래스별 합성 이미지도 1개로 제한하도록 하겠습니다.
이미지 합성성능을 향상시키기 위해서는 9. 하이퍼파라미터 정의 부분을 수정하시거나 데이터 응축에 사용되는 모델(베이스라인은 단순 MLP 모델)을 다른 모델로 변경하는 등의 방법을 사용하실 수 있습니다.
참가자가 합성한 데이터셋으로 훈련된 VGG16모델이, FashionMNIST 테스트 훈련 셋에 대해서 예측한 label을 실제 ground truth label과 비교한 정확도로 데이터셋 응축 성능을 평가하게 됩니다. 즉 합성된 데이터셋이 얼마나 FashionMNIST 데이터셋의 전체적인 특성을 잘 합성하였는지 여부를 평가하게됩니다.