데이터셋은 AI-Hub에 공개된 한국 이미지(음식) 데이터셋을 활용합니다.
데이터셋 출처 : https://www.aihub.or.kr/aihubdata/data/view.do?currMenu=116&topMenu=100&aihubDataSe=ty&dataSetSn=79
보다 쉬운 챌린지를 위해 총 12개의 대분류 밑에 150개의 소분류로 나눠져 있지만, 12개의 대분류를 분류하는 문제로 정의합니다.
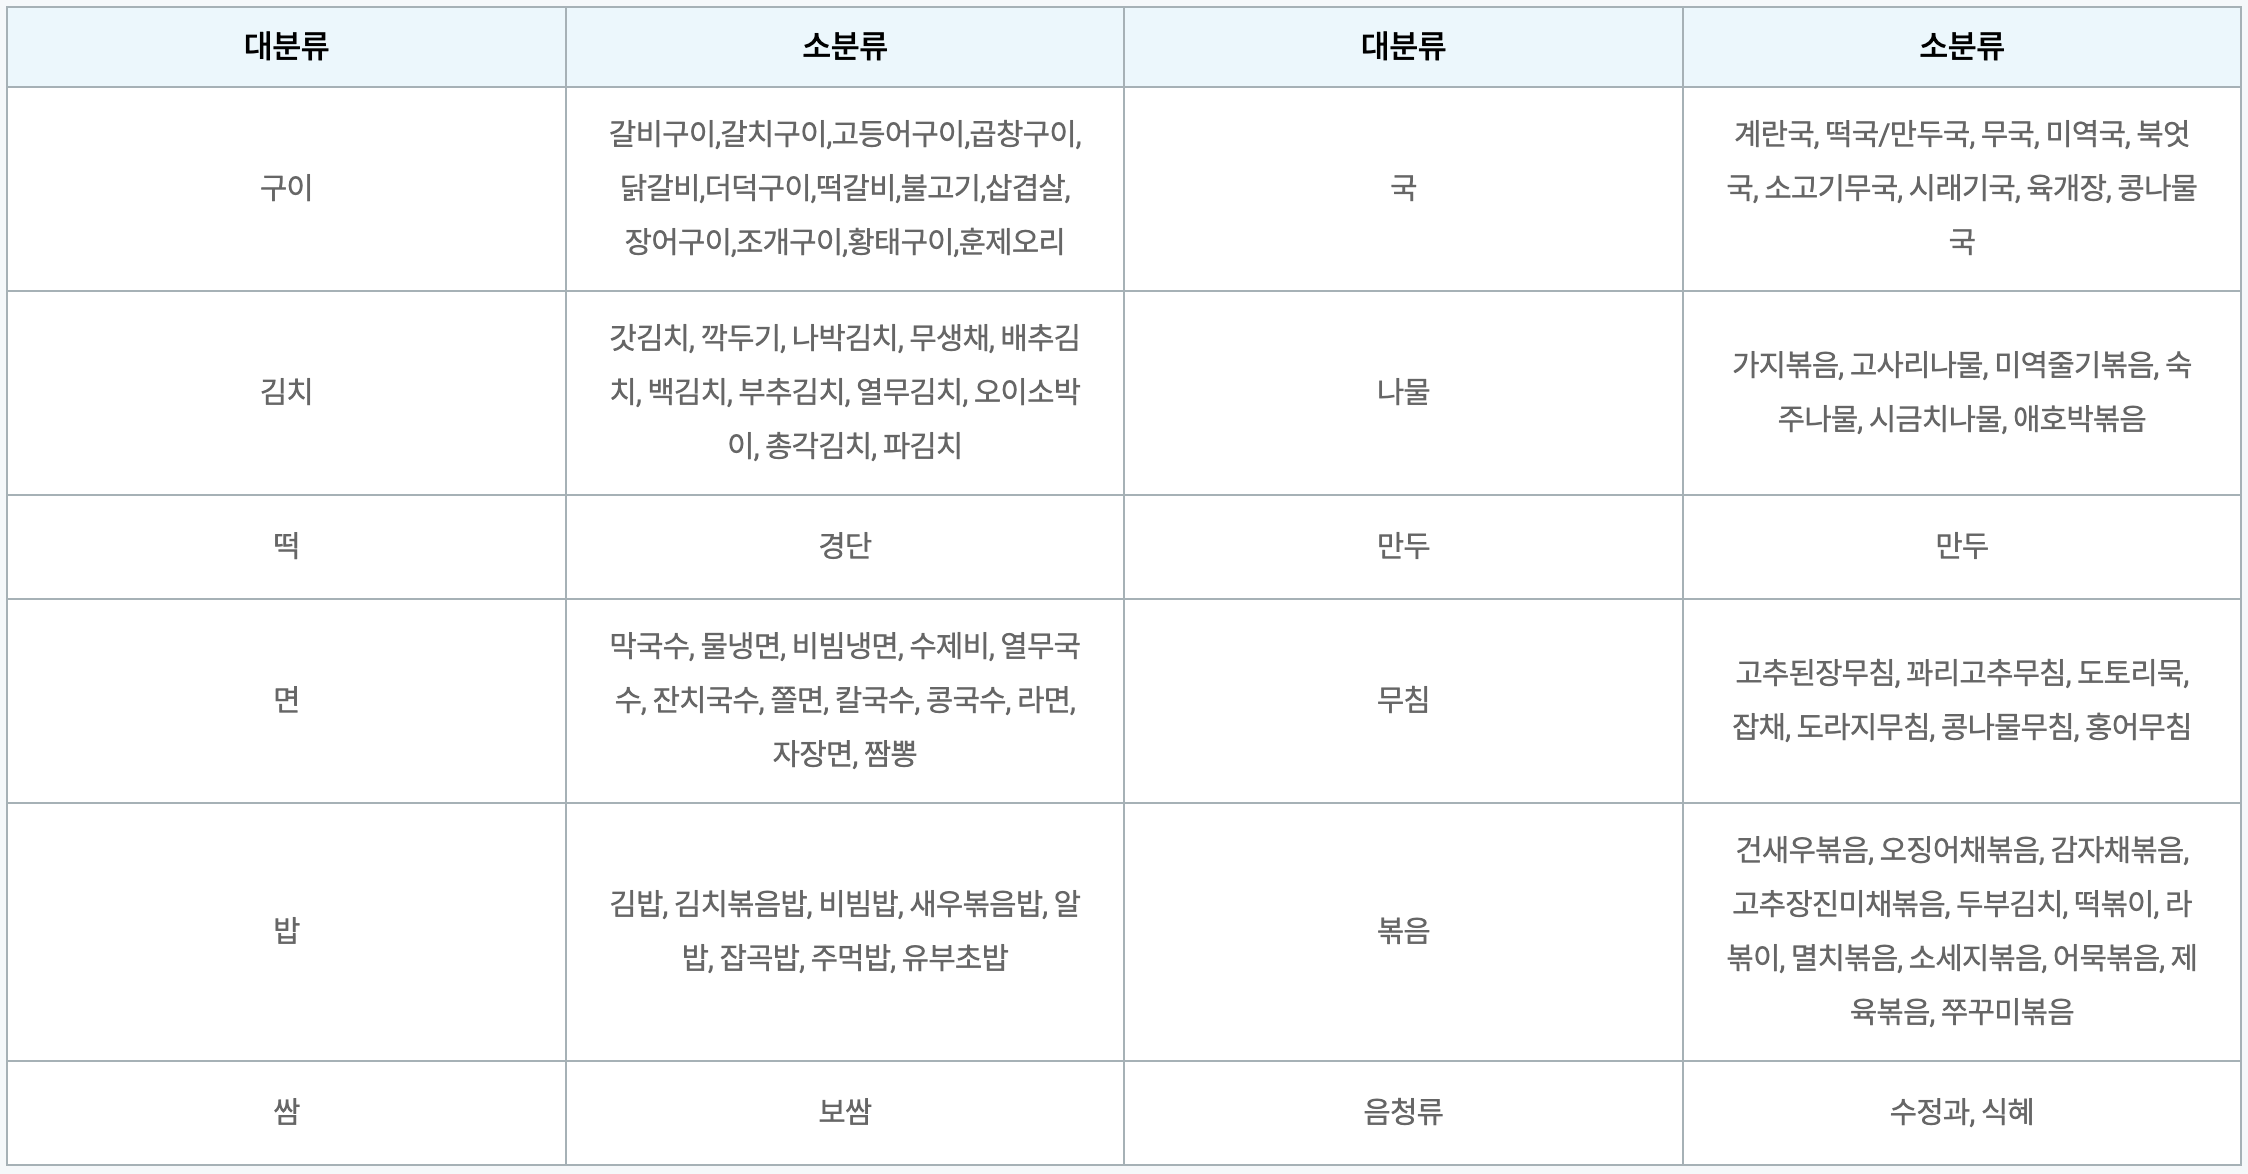
학습 데이터셋은 12개의 대분류당 10개의 데이터가 주어져 총 120개의 학습데이터셋으로 구성됩니다.
각 12개의 대분류마다 1개의 소분류를 선정해 sub dataset을 구성합니다. 예) 구이-갈비구이, 김치-갓김치, 국-계란국 과 같이 하나의 대분류에 해당하는 소분류 하나만을 사용합니다.
테스트 데이터셋은 12개의 대분류당 100개의 데이터가 주어져 총 1200개의 테스트데이터셋으로 구성됩니다.