AI HUB에 공개되어있는 텍스트 데이터 중 비윤리 검증 텍스트를 사용하였습니다.
정치, 인간 관계, 회사 등 여러 환경에서 사용하는 문법들을 Json 파일에서 각 각 key-value로 데이터를 담았습니다.
AI HUB에서 제공하는 Training Dataset을 사용하였습니다. 참가자들은 해당 Dataset을 이용한 모델 수행에 대한 결과값을 제출해야합니다.
데이터 다운로드 클릭
set.zip를 코랩 베이스라인에 업로드 후
베이스 라인 실행
모델 학습 관련 설정 set/class.json 파일
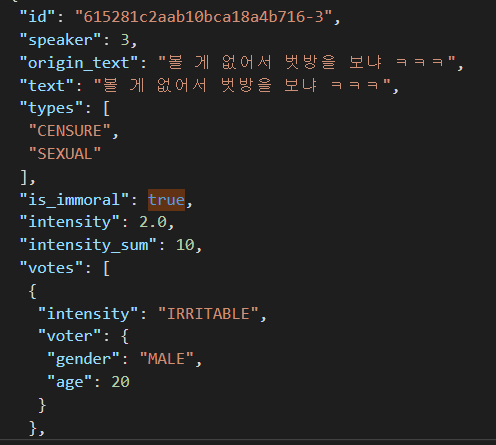
딕셔너리 형태로 key-value를 가지고 있습니다.
id - 각 문장(텍스트)에 대한 고유 인덱스
origin_text - 데이터셋의 핵심인 비윤리 문장
text - AI Hub에서 origin_text를 가공 한 것.
is_immoral - AI Hub에서 지정한 윤리/비윤리 문장에 대한 여부
intensity - 비윤리성에 대한 강도, 0을 기준.
votes→gender - 문장을 말한 사람의 성별
votes→age - 문장을 말한 사람의 나이
talksets-train-1 ~ 5 총 5개의 학습 데이터셋이 있습니다, 이는 각 정치, 인간관계 등의 여러 상황에서의 비윤리 문장의 데이터를 가지고있습니다.
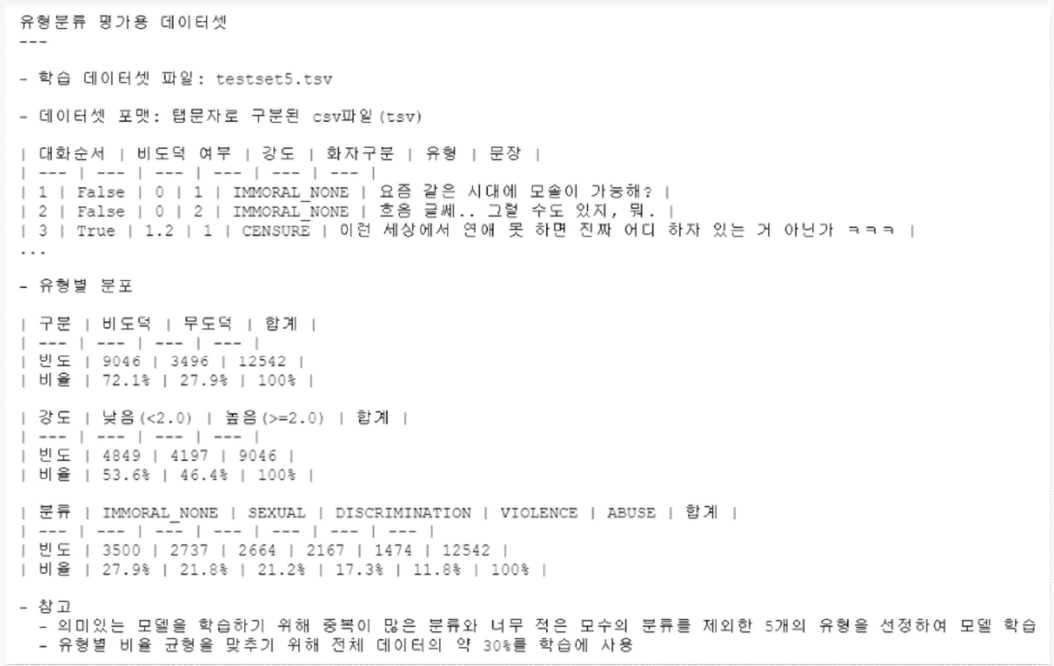
기본 적으로 한글을 베이스로 하고 있기때문에, 영어에 대한 비속어 데이터는 없습니다.
또한 데이터셋의 문장은 표준어로 구성되어 있기 때문에 방언은 속해있지 않습니다.
talksets-train-4.json | — |