[분야1] 완전 자율 네트워크 운영을 위한 초단기 네트워크 트래픽 예측
기간
2025.08.01 - 2025.08.31
총 상금
1200만원
참가자수
136
조회수
21,911
기간
2025.08.01 - 2025.08.31
총 상금
1200만원
참가자수
136
조회수
21,911
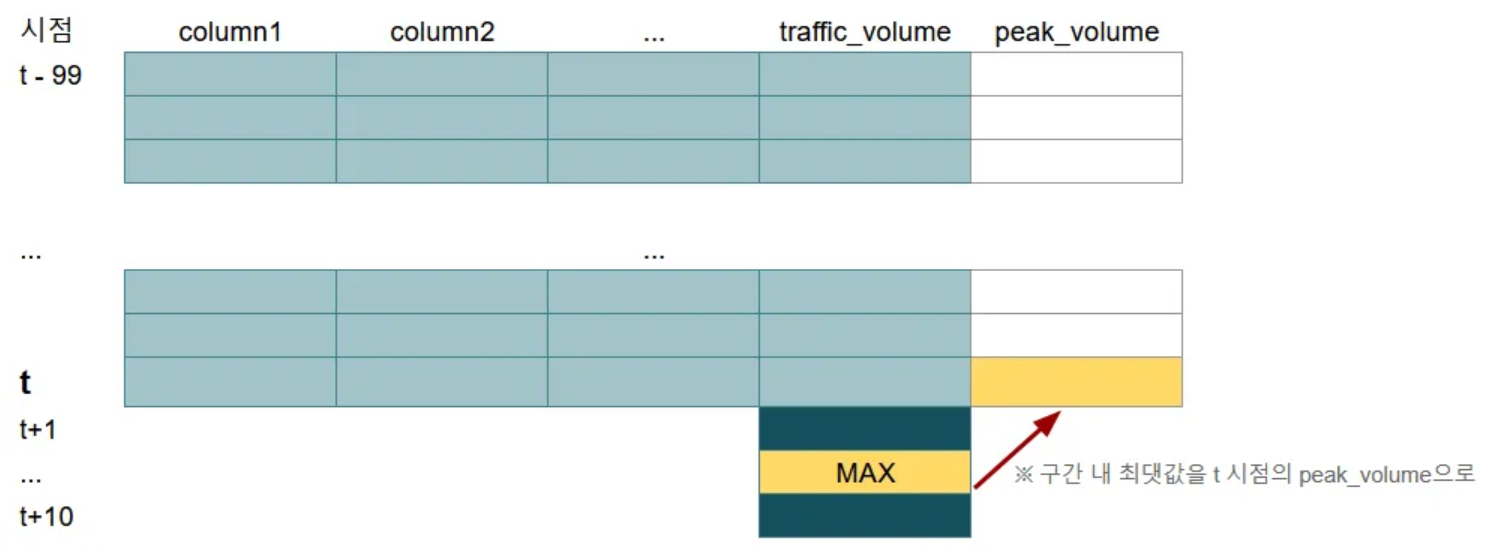
최대 10초 간의 데이터를 이용하여 향후 1초 사이를 100milisecond간격으로 10개로 나누었을때 그 중 traffic_volume 최댓값을 예측합니다.
입력: 현재 시점을 t라고 할 때, 최대 100개 과거 시점(t ~ t-99)까지의 관측값
출력: t 이후 10개 시점 (t+1 ~ t+10) 사이의 traffic_volume 최댓값
peak_volume 이라는 column으로 사전에 정의
모델 입력 길이는 1~100까지 자유롭게 활용 가능합니다. (예: t ~ t-9까지 10개 시점만 사용)
학습데이터(train_data.csv)는 참가자 분들께서 학습하고자 하는 형상에 맞게 편집하여 사용할 수있도록, 사전에 peak_volume 값만 할당한 형태의 .csv로 제공됩니다.
평가데이터(test_input_data.pkl)는 제출 이후 추론 환경에서 time-series 처리를 편리하게 수행할 수 있도록 각 샘플별로 100개 시점 입력값을 numpy array 형태로 제공합니다. (※ peak_volume 제외)
최대 100개 시점 내에서 원하는 만큼을 입력 길이로 지정할 수 있습니다.
예) t 포함 10개 시점만 사용하는 경우, 각 입력 샘플의 마지막 10개 시점만 잘라서 입력으로 사용 → 인덱싱 = [-10: , :]
상세한 형상은 아래 데이터 설명 부분과 제공되는 test_inputs_sample.pkl. test_outputs_sample.pkl을 참고합니다.
본 대회는 일반적인 대회와 달리 ‘추론 결과’가 아닌 ‘모델’을 제출하는 ‘추론자동화’ 방식으로 결과를 제출합니다.
테스트셋이 참가자분들께 제공되지 않으며, 평가는 보안 환경 내에서 제출된 모델에 평가데이터를 적용하여 자동으로 수행됩니다.
모델 제출 방식은 [베이스라인] 탭에 제공되는 모델 및 코드 내용(task.ipynb)을 참고합니다.
일 10회 제출이 가능하며, 이전 제출 결과가 나온 뒤 10분 후부터 재제출하실 수 있습니다.
🗂️task1_data.zip
├── 📈 train_data.csv - 학습 데이터 (입출력)
├── 📈 test_inputs_sample.pkl - 평가 데이터 입력 샘플
├── 📈 test_outputs_sample.pkl - 평가 데이터 정답 샘플
├── 📈 test_inputs_columns.csv - 평가 데이터 컬럼
└── 📈 t1_codebook.csv - 데이터 컬럼 설명
※ 평가 데이터는 미제공
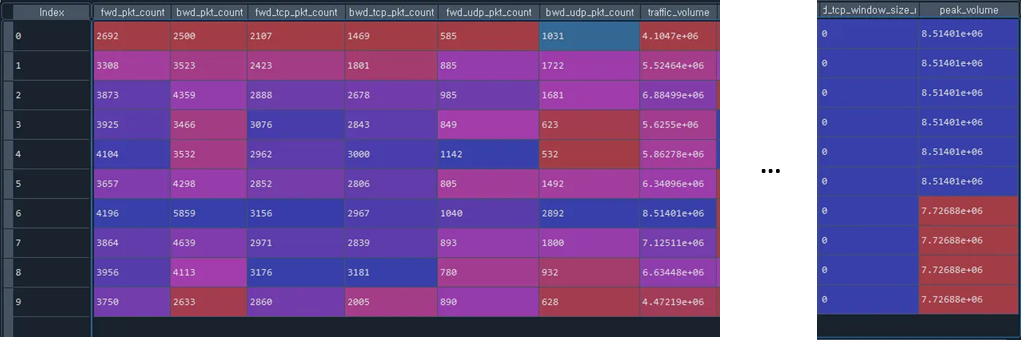
700,000 rows x 28 cols로 이루어진 csv 파일
각 row는 단일 대상을 100 milisecond 간격 (1/10초)으로 관측
컬럼 정보:
fwd_pkt_count: forward 방향 전체 패킷 수
bwd_pkt_count: backward 방향 전체 패킷 수
fwd_tcp_pkt_count: forward 방향 tcp 패킷 수
bwd_tcp_pkt_count: backward 방향 tcp 패킷 수
fwd_udp_pkt_count: forward 방향 udp 패킷 수
bwd_udp_pkt_count: backward 방향 udp 패킷 수
traffic_volume: 트래픽 크기 (bytes)
peak_volume: 현 row의 시점을 t라고 할 때, t+1 ~ t+10의 1초 가운데 발생한 traffic_volume의 최댓값
기타 column 항목들의 의미는 t1_codebook.csv 참고
구성 예)
입력데이터:
100 × 27 크기의 numpy array 163,854개
shape = (163854, 100, 27)
100 rows는 순서대로 t-99 ~ t 까지의 관측값
컬럼 구성은 학습데이터와 동일 (peak_volume 제외)
test_set_columns.csv 참고
파일경로: “/aif/data/test_inputs.pkl”
출력데이터(레이블):
163,854 × 1 크기의 numpy array
입력데이터의 샘플별 t시점(=마지막 row)에 해당되는 peak_volume값
= t+1 ~ t+10 시점의 traffic_volume 최댓값
입력데이터와 동일한 인덱스끼리 입출력 1 set을 구성
실제 평가 입력, 출력 데이터 형상은 각각의 sample pkl 파일을 참고
test_inputs_sample.pkl
test_outputs_sample.pkl
본 태스크는 모델을 제출하여 자동 추론 방식으로 평가를 수행하므로, 추론용 모델 스크립트에서 결과를 파일로 저장하도록 구성합니다.
총 163,854 개 peak_volume 값을 ”submission.pkl”로 저장
numpy array 형태 (※ tensor가 아님에 주의)
전체 제출 방식은 추론자동화 가이드 참고 ([베이스라인] 탭)
기본 MAE를 평가지표로 하되 추론 시간을 최종 순위에 보정합니다.
평가 지표: MAE
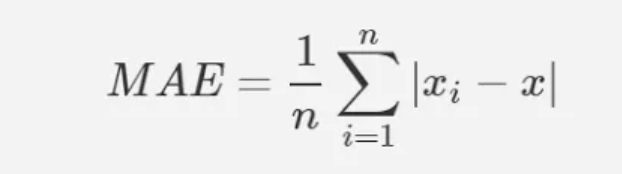
Task 순위 산정 방식:
기본적으로 리더보드 스코어의 MAE가 작을수록 높은 순위가 부여됩니다
MAE 차이가 조밀하여 다음 순위(들)과의 MAE 차이가 0.1% 이내인 경우 추론 속도가 더 빠른 쪽을 더 높은 순위로 조정합니다.
% 차이 산정 방식: 높은 순위 MAE를 분모로 하여, 차순위 MAE에서 높은 순위 MAE를 뺀 값을 분자로 %계산
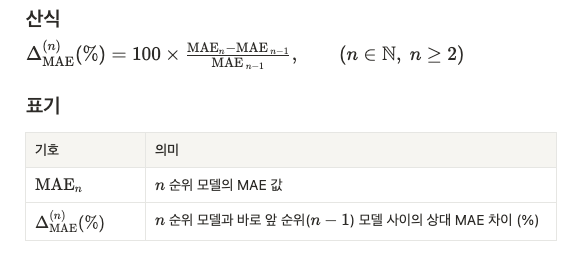
공정한 심사를 위해 참가자 여러분의 최적화된 성능 제출을 권장드립니다.
추론속도(추론 경과 시간)에는 [데이터 전처리 + 모델 추론] 시간이 카운트됩니다. 자원 대기, 환경 생성, 라이브러리 설치 등에 걸리는 시간은 가산되지 않습니다.
상위 20개 팀의 추론 시간은 매일 정오에 갱신되어 [개요]탭 상단에 공지됩니다.
traffic volume 예측 관련 논문
Q. He, A. Moayyedi, G. Dán, G. P. Koudouridis, and P. Tengkvist, “A Meta-Learning Scheme for Adaptive Short-Term Network Traffic Prediction,” Ieee J Sel Area Comm, vol. 38, no. 10, pp. 2271–2283, 2020, doi: 10.1109/jsac.2020.3000408.
I. Frommholz et al., “Unlocking the Potential of Deep Learning in Peak-Hour Series Forecasting,” Proc. 32nd ACM Int. Conf. Inf. Knowl. Manag., pp. 4415–4419, 2023, doi: 10.1145/3583780.3615159.
flow 식별 관련 논문
A. Majidi, N. Jahanbakhsh, X. Gao, J. Zheng, and G. Chen, “DC-ECN: A machine-learning based dynamic threshold control scheme for ECN marking in DCN,” Comput. Commun., vol. 150, pp. 334–345, 2020, doi: 10.1016/j.comcom.2019.10.028.